


La UNR fue sede de la “Datathon Regional: Evaluación sociocultural de los grandes modelos de lenguaje”, un evento internacional que convocó a 23 Universidades.
Estudiantes de la Universidad Nacional de Rosario se sumaron al desafío de poner a prueba y “engañar” a los grandes modelos de lenguaje con el objetivo de mejorar sus conocimientos sobre América Latina.
Los grupos estuvieron formados por estudiantes de las Licenciaturas en Relaciones Internacionales, Ciencia de Datos, Estadística y Comunicación Social, así como de la tecnicatura en Inteligencia Artificial que pertenecen a tres facultades: Ciencia Política y Relaciones Internacionales, Ciencias Exactas, Ingeniería y Agrimensura y Ciencias Económicas y Estadística. A nivel macro, la competencia logró convocar a un total de 188 estudiantes pertenecientes a 23 universidades de 6 países de la región.
Para garantizar la diversidad de enfoques, el reglamento oficial exigió que los equipos (compuestos por entre 4 y 5 integrantes) fueran interdisciplinarios. Cada grupo debió combinar al menos un estudiante con formación en ciencias exactas o ingeniería, junto con al menos un integrante del área de humanidades o ciencias sociales, valorando especialmente la diversidad regional, cultural y de género.
El desafío de descolonizar la IA y exponer sus sesgos
El problema central que motivó este encuentro es que los grandes modelos de lenguaje no representan a todos los idiomas y culturas por igual. Si bien estas tecnologías tienen un uso masivo en la región —con países como Chile donde el 76% de la población adulta las utiliza, y Brasil posicionándose como el tercer mercado mundial para OpenAI—, los datos con los que se entrenan provienen mayoritariamente de países del Norte y están en idioma inglés. Esto genera contenidos sesgados o vacíos de conocimiento cuando se aplican a los contextos culturales del Sur.
Frente a esta situación, la Datathon Regional buscó realizar un diagnóstico profundo de los sesgos culturales, lingüísticos, históricos, de género y de minorías presentes en la IA generativa. El evento fue organizado por Inria Chile, apoyado por el Ministerio de Europa y Asuntos Exteriores de Francia, la red de Embajadas de Francia y las universidades latinoamericanas (quienes actuaron como Operadores Locales).
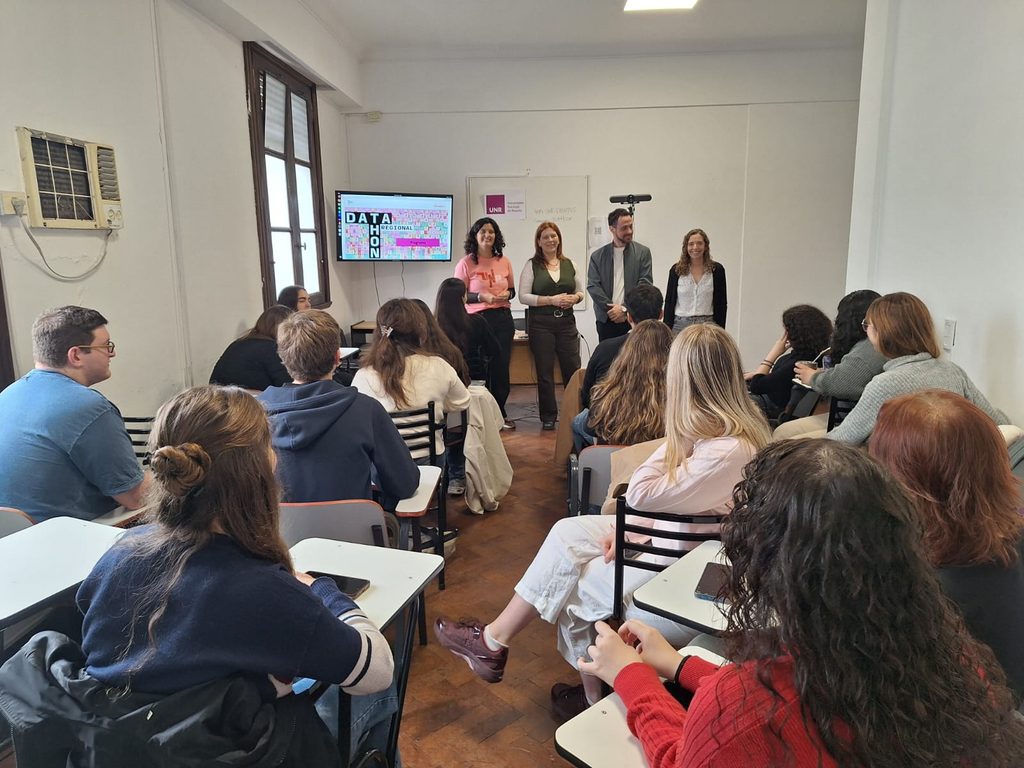
Durante el 3 de octubre, desde las 11 hasta las 21 horas, los participantes se dedicaron a crear conjuntos de preguntas diseñadas específicamente para capturar conocimientos de su región, país o cultura. La tarea consistió en seguir el modelo de preguntas de opción múltiple, formulando una respuesta correcta y tres “distractores” plausibles en idioma local (español o portugués), incluyendo además una versión obligatoria en inglés.
Para que las preguntas tuvieran rigor metodológico, los estudiantes debieron agregar metadatos obligatorios (país, región, dimensión cultural y nota contextual) y vincularlas a páginas de Wikipedia. En caso de no existir contenido en Wikipedia, se requería una justificación de origen cultural. Además, las bases fueron claras respecto a las descalificaciones: se eliminaban las entregas basadas en datos efímeros o rumores, opiniones, trivias sin valor sociocultural, errores factuales o aquellas que promovieran estereotipos dañinos y contenido discriminatorio. Los participantes se comprometieron formalmente a no usar herramientas de inteligencia artificial generativa durante el desafío.
El sistema de evaluación constó de una revisión inicial mixta que combinó análisis de similitud de texto y revisión humana, para luego pasar a un panel compuesto por los propios LLMs. El puntaje final de cada equipo dependió de su capacidad para “engañar” exitosamente a estos modelos dentro del marco normativo, mostrando su desempeño en un ranking que se actualizó regularmente durante todo el evento.
Todas las contribuciones originales de los estudiantes pasarán a integrar la próxima versión del dataset abierto “LatamQA”, bajo la licencia Creative Commons CC-BY-4.0. Este recurso es fundamental para contar con un marco de evaluación sociocultural de las inteligencias artificiales centrado en la identidad latinoamericana.
El equipo que alcance la puntuación más alta a nivel regional será galardonado con un premio de 2.000 euros que se repartirá equitativamente entre sus miembros, además del reconocimiento en futuras publicaciones científicas vinculadas al dataset. También se contempló la posibilidad de que los Operadores Locales otorguen reconocimientos a nivel institucional.
Como cierre de esta iniciativa, un video recapitulativo de la Datathon será difundido en la sesión inaugural del IV Encuentro de Ciencia Abierta Francia – América Latina, que tendrá lugar en Montevideo, Uruguay, del 28 al 30 de octubre de 2026.
Periodista: Victoria Arrabal